
━━━━━━━━━━━━
分享這篇分析
把這篇文章轉給關注生技醫藥、公司研究或資本市場的朋友。
AI for Science 最常被吐槽的一句話是:它可以一次提出一百個假說,最後還是得有人進實驗室,慢慢把答案做出來。
Google 的最新預印本,第一次把這個問題往前推了一大步。
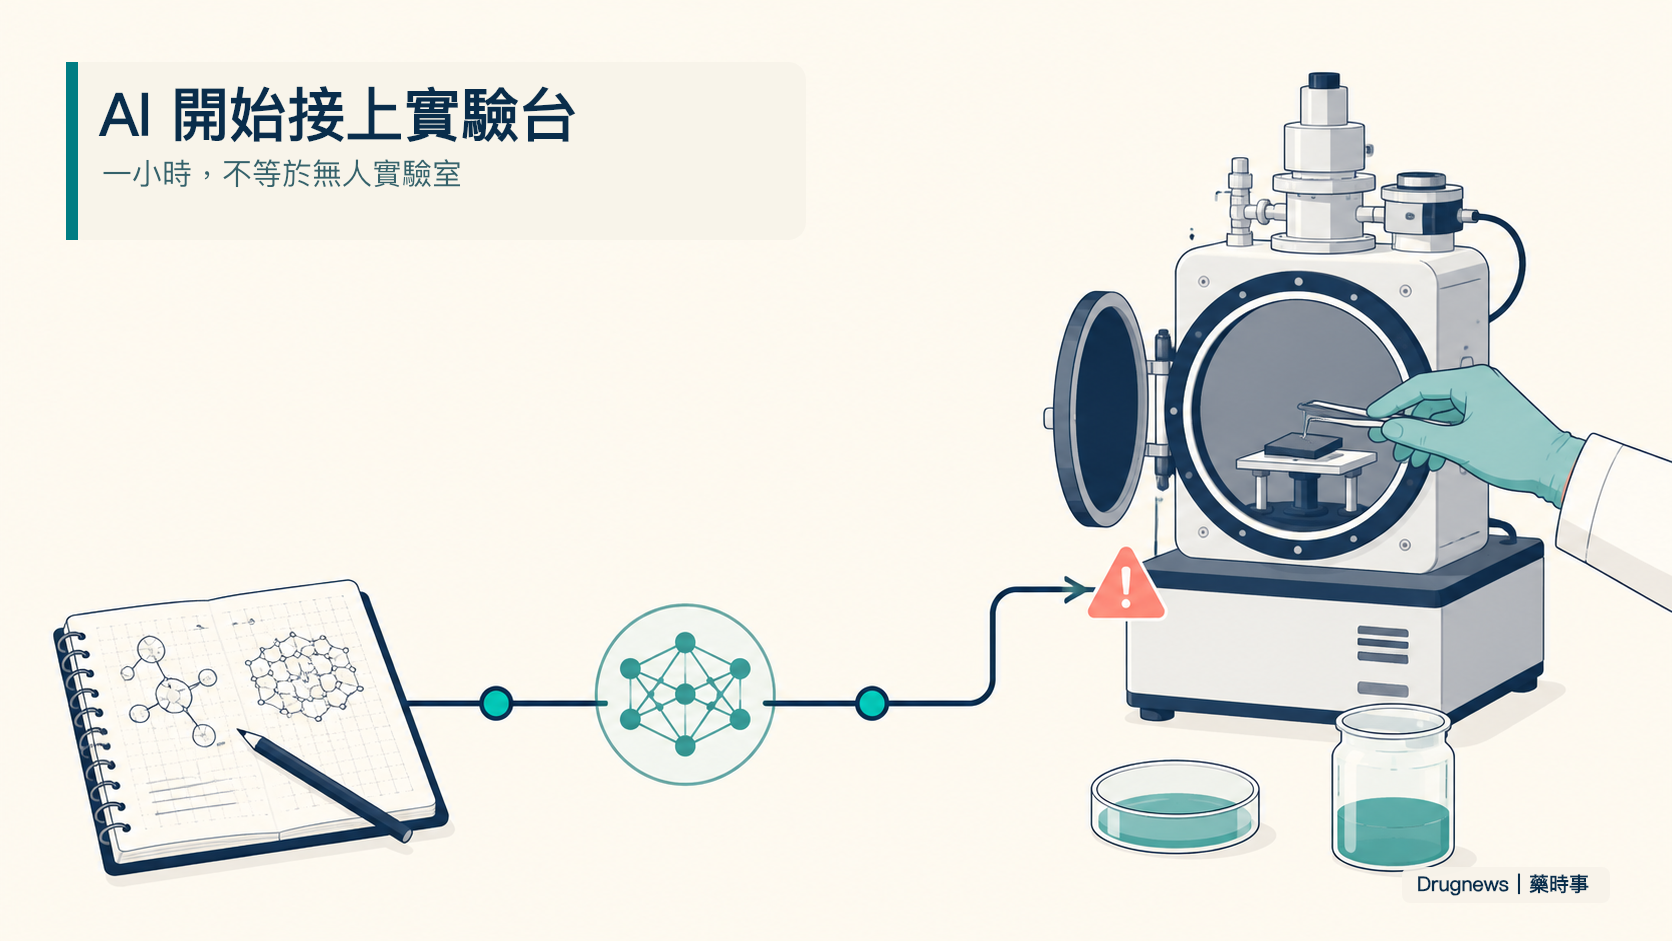
研究團隊把 Gemini 驅動的 Co-Scientist,從原本擅長的假說生成,延伸成三段流程:提出構想、執行實驗、根據紀錄寫成論文。在其中一個材料案例裡,系統甚至把合成配方轉成機器指令,直接控制半自動化學氣相沉積設備。
最吸睛的結果是:MoS₂、MoSe₂、WS₂ 三種單層材料,在第一次成長嘗試中成功,整段實驗時間約一小時。
不過,這句話少一個限定,就會從突破變成誤導。
這段約一小時的結果有明確適用範圍:特定材料、客製 CVD 設備、既定成長任務。人類仍要裝載前驅物與基板,研究團隊也要負責驗證。論文目前還是預印本,跨實驗室能不能重現,尚未知道。
「一小時」只是最醒目的數字。更大的變化在於,AI 開始碰到研究流程中最難接上的那一段:從文字推理走到可執行的實驗。
━━━━━━━━━━━━
🧠 01|新版 Co-Scientist,多了哪兩段?
早期 Co-Scientist 的重點,是讓多個 Gemini agents 生成、辯論、排序並改寫研究假說。
新版把流程往後延伸:
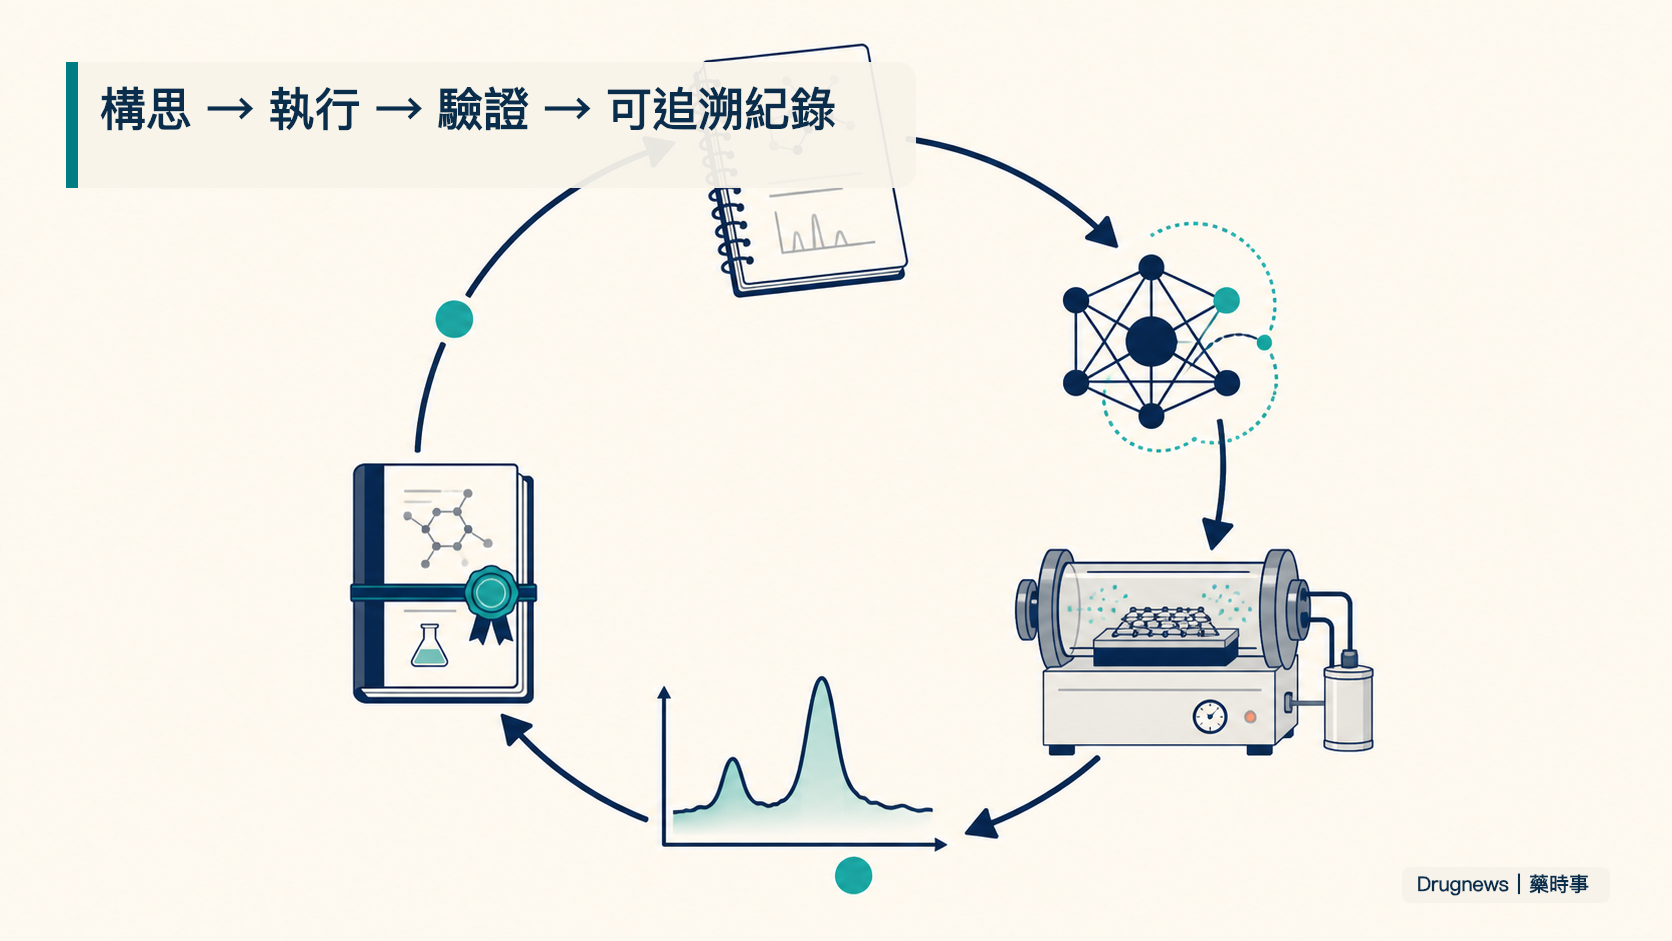
① Ideation|構思:多個 agent 找文獻、提出假說、互相批評,再排出值得測試的方向。
② Experimentation|實驗:把研究計畫轉成程式、參數或機器指令,執行後依結果迭代。
③ Paper Writing|寫作:讀取真正的實驗輸出與執行紀錄,生成手稿並檢查方法、結果與引用。
這三段串起來,才有機會形成「提出假說—做實驗—讀結果—改下一輪」的閉環。
但閉環不等於全自動。
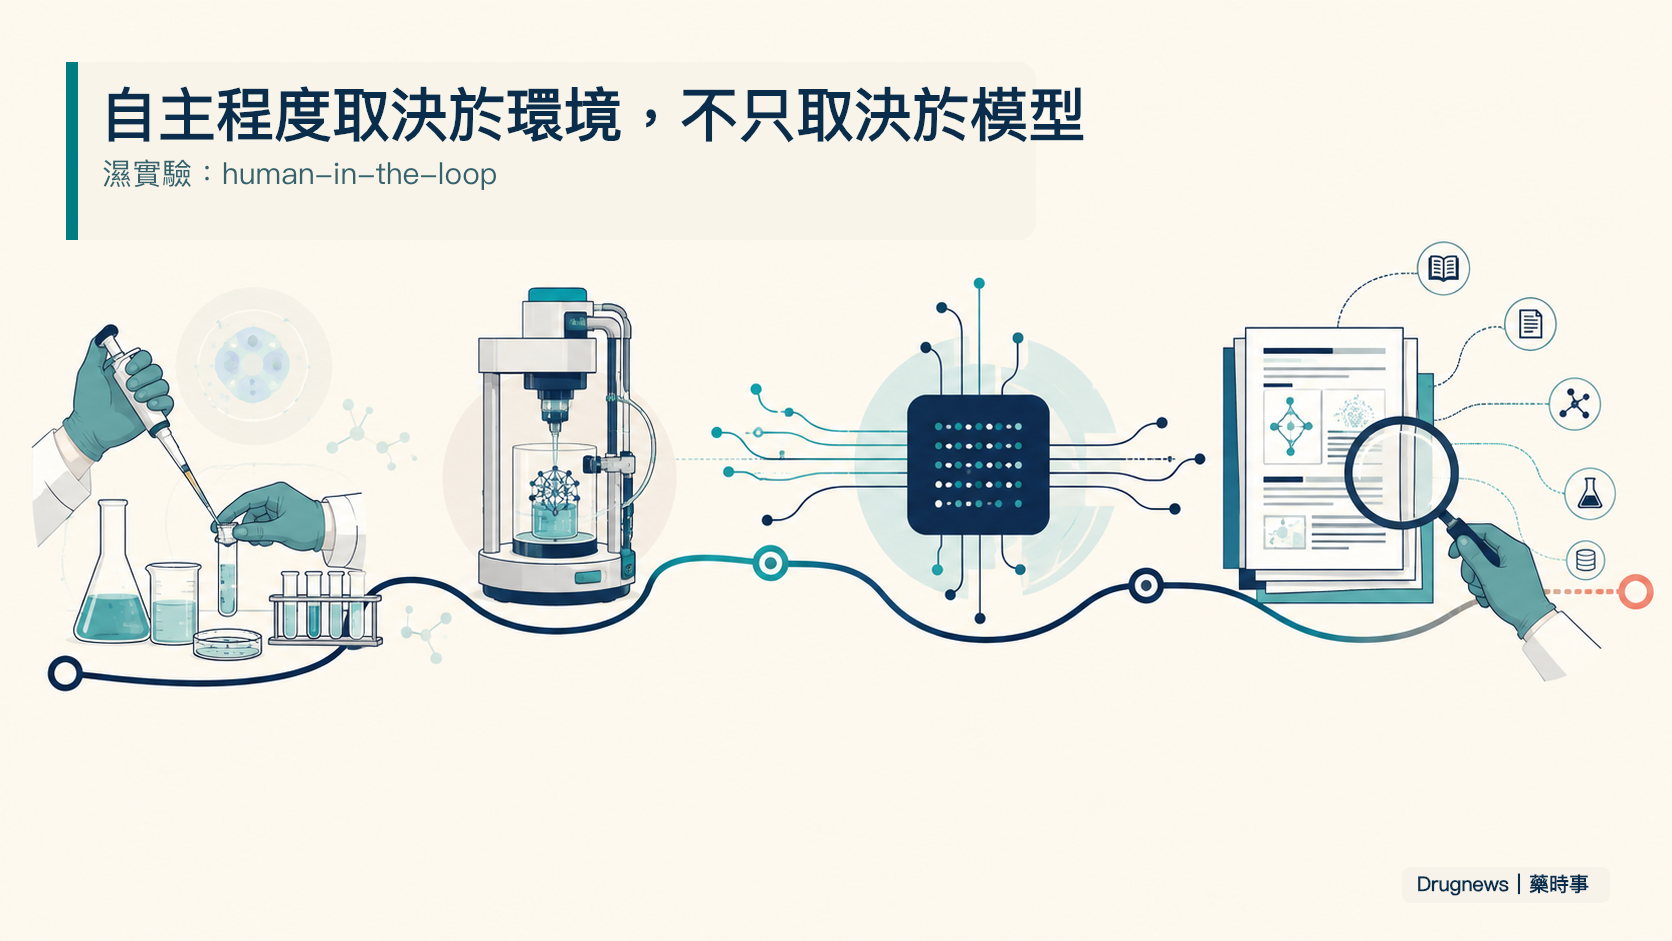
論文刻意把不同領域放在一張自主程度光譜上:材料實驗有人操作設備,生物學有人反覆修正任務並做濕實驗,電腦科學因為所有步驟都能程式化與打分,才真正做到從研究指令到實驗完成的全自主。
━━━━━━━━━━━━
⚗️ 02|「約一小時」到底發生了什麼?
材料科學團隊測試了兩種模式。
完整搜尋模式會花較多推理資源,產生並排名多組配方,再由專家挑選;快速模式則讓 Gemini 3 Deep Think 在幾分鐘內,依照實驗室設備、溫度與氣體條件調整成長配方,並把配方直接轉成控制 CVD 設備的機器碼。
在快速模式下,MoS₂、MoSe₂、WS₂ 都在第一次成長嘗試中出現單層晶體,總實驗時間約一小時。論文所述「至少五次」的 replication runs 僅適用於 MoSe₂ 與 WS₂;MoS₂ 不能一併寫成已完成至少五次重複。
這裡有三個不能被標題吃掉的限制:
🔸 人類仍要把前驅物與基板放進設備;
🔸 快速模式長出的晶域較小、形狀較不規則,速度有品質代價;
🔸 成果來自研究團隊的客製設備,換一座實驗室能不能直接複製,還沒有答案。
另一個 MXene 案例也更接近「AI 配方、人類執行」。Co-Scientist 提出較安全的前驅物路徑,專家優化後實際合成出具有關鍵相似特徵的層狀結構;作者明確提醒,原子結構仍需更多實驗確認。
所以最精確的說法是:AI 已經能參與控制某些可程式化的成長步驟,但距離自主判斷所有物理異常、維護設備與確認新材料身分,還差很遠。
━━━━━━━━━━━━
🧫 03|四個驗證領域,不能放在同一個「全自主」標籤裡
這篇論文最值得讀的地方,是它沒有用單一案例代表所有科學。
材料科學:AI 產生配方,部分流程可直接控制硬體;人類仍裝載、操作、表徵與確認。
生物學:Co-Scientist 從稀疏影像,預測工程化大腸桿菌在不同誘導濃度下的群聚表型;領域專家在不同回合修正問題,濕實驗也由人執行。
電腦科學:系統只收到研究指令,便自主設計出 Agent_H、寫程式、測試並迭代。因為環境可以被程式控制,這才是四個案例中自主程度最高的一段。
論文寫作:系統讀取執行紀錄產生研究手稿,再由 30 位領域專家完成 450 次盲評。
把四項結果全部寫成「AI 科學家自己做完研究」,會掩蓋真正重要的結論:自主程度同時取決於模型、實驗能否程式化、結果能否客觀評分,以及風險能否被安全約束。
━━━━━━━━━━━━
🩺 04|Agent_H「打贏前沿模型」,也有一個大括號
Co-Scientist 在電腦科學案例中,自主設計了一套醫療問答 agent 架構 Agent_H。
在兩個未參與開發的 HealthBench 測試中,Agent_H 的「長度調整後分數」居首;可是看原始分數,HealthBench Professional 的第一名是 Claude Opus 5,HealthBench Hard 在另一位自動評審下則是 GPT-5。
Agent_H 每題大約要呼叫模型 40 至 80 次,對照組則是一次呼叫。這表示分數提升至少部分來自更多推理與多輪稽核,成本不能省略。
更重要的是醫師盲評。
三位醫師比較 Agent_H 與 Gemini 3.1 Pro 後,只有「降低潛在傷害」達統計顯著,其餘八個面向沒有顯著差異;自動評審與臨床評審的絕對偏好一致性也不高。
它證明 agent 架構可以改善某些輸出品質,沒有證明 AI 已能替代醫師,更不是一張臨床使用許可。
━━━━━━━━━━━━
📝 05|把實驗紀錄綁回手稿,幻覺降很多,但沒有消失
研究團隊讓 Co-Scientist 根據真正的程式執行紀錄寫手稿,並加入結果核對、引用檢查、安全審查等模組。
150 篇手稿經 30 位專家、450 次盲評後,嚴重結果幻覺從基準系統的 90% 降到 4%;嚴重方法學偏差從 100% 降到 24%;高嚴重度衍生/抄用內容也從 60% 降到 16%。
這組數字有兩種讀法。
樂觀的一面,是「把模型綁回原始紀錄」確實有效;冷靜的一面,是每四篇仍約有一篇出現嚴重方法學偏差。
而且這套驗證主要適用於有清楚執行日誌與客觀輸出的運算研究。到了真實濕實驗,儀器雜訊、樣品差異與模糊讀值更難自動核對。作者也把這一點列為限制。
AI 科學寫作接下來最值錢的能力,不會只是「寫得像論文」,而是每一個方法和數字都能回到原始紀錄。
━━━━━━━━━━━━
💼 06|Google 想拿下科學閉環的入口
Google 早已把 Co-Scientist 放進 Gemini for Science:Hypothesis Generation 處理假說,Computational Discovery 處理可程式化實驗,Literature Insights 整理文獻;Science Skills 再連接外部生命科學工具。
這次研究又往下接到硬體控制與論文稽核。
如果這條路成立,平台最深的價值會落在研究團隊每天反覆使用的流程:問題怎麼被拆、哪個工具被調用、哪些實驗失敗、參數怎麼改、最後哪個證據改變決策。聊天席位只是入口。
真正的護城河會落在四個地方:
① 能否安全連接不同實驗設備;
② 實驗紀錄是否完整、可追溯;
③ 同一套流程能否跨設備、跨實驗室重現;
④ 客戶是否願意把珍貴的內部資料與操作流程留在平台上。
━━━━━━━━━━━━
🇹🇼 07|台灣真正的機會:把可驗證場景做出來
台灣有材料、半導體、生醫、醫院與儀器整合能力,確實很適合測試這類 lab-in-the-loop 系統。
不過,截至查核日,Google 與論文的一級來源沒有具名任何台灣上市櫃/興櫃公司參與本案,也沒有可辨識的設備訂單或合作收入。
因此,不能因為公司做伺服器、實驗設備或生醫服務,就直接標成受益股。
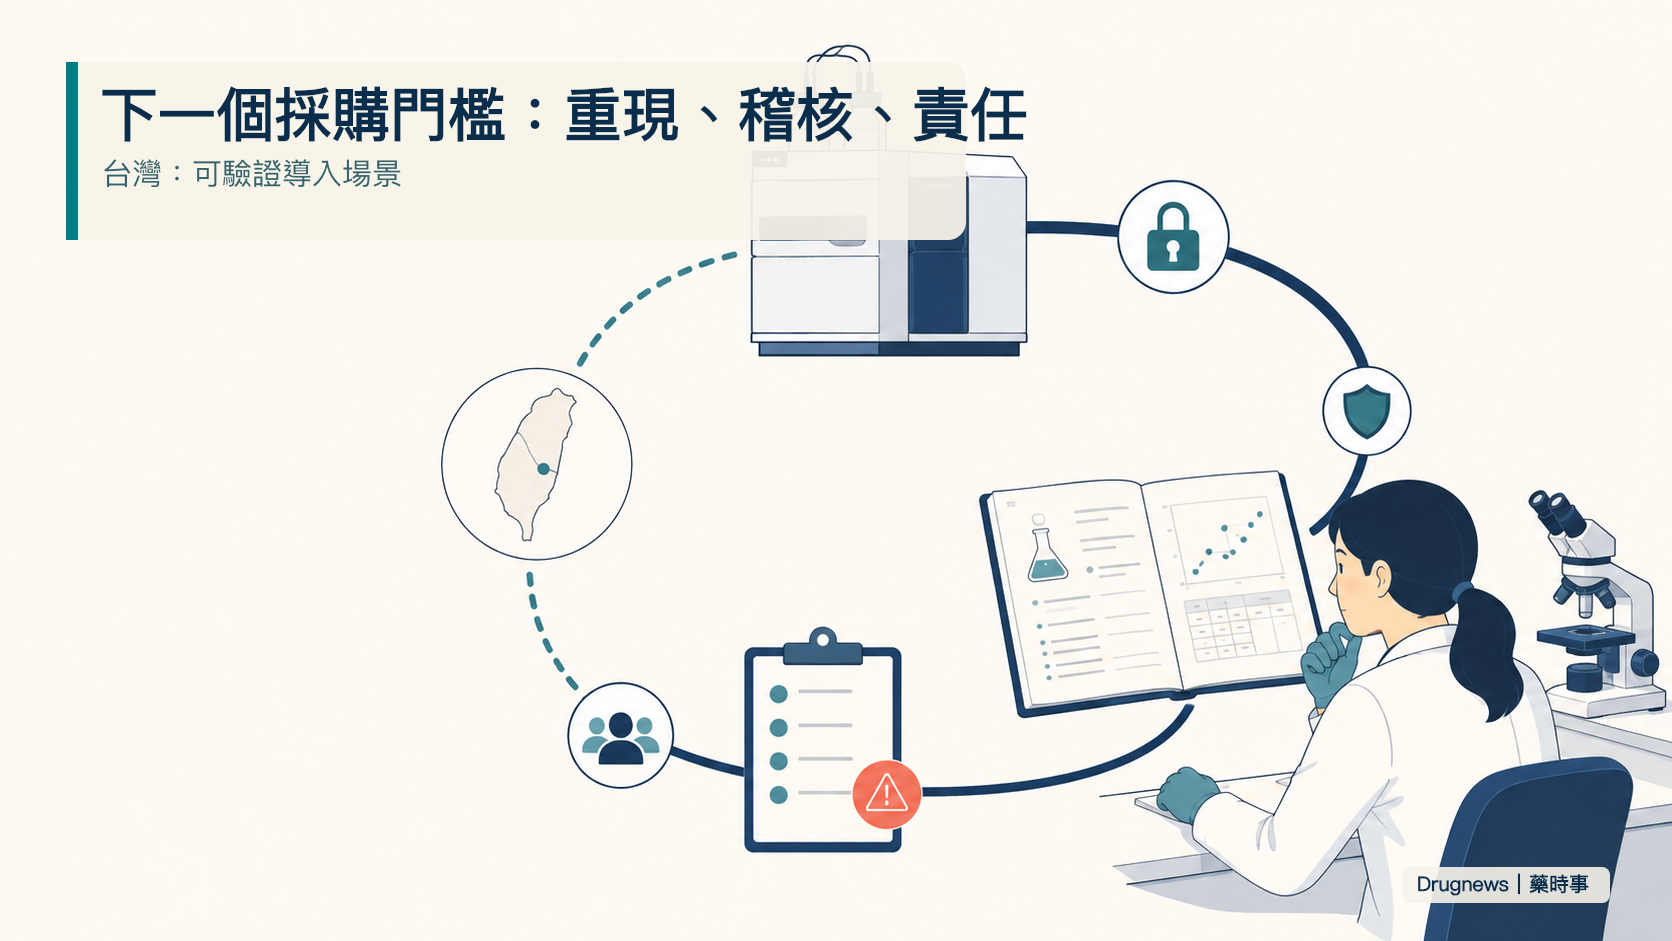
台灣更該追的是三個訊號:
🔎 是否出現由研究機構或公司公告的具名導入;
🔎 同一套實驗配方能不能跨實驗室、跨設備重現;
🔎 AI 指令、設備安全、資料留存與責任歸屬能不能通過治理審查。
這三項一旦成熟,價值才會從漂亮 demo 走向可採購的基礎設施。
━━━━━━━━━━━━
🔬 08|一個實驗室閉環,究竟要賣給誰?
把 Co-Scientist 想成「一個更會回答問題的模型」,很容易把商業重點看小。研究現場真正花錢的地方,是一個問題從提出到被相信,中間每一次交棒都不能掉球:PI 要確認問題值得做;研究員要把條件寫成設備能讀的語言;儀器要留下原始訊號;團隊要知道哪一次失敗是材料、操作還是模型建議造成;最後,結果進入報告前還要被另一個人追問。
Google 這次把其中幾個交棒點接了起來。它的潛在客戶不只是一位使用聊天機器人的博士生,而是擁有大量儀器、歷史資料與合規負擔的研發組織。這類客戶採購的從來不是一句「模型很聰明」,而是一套能否接進既有 ELN、LIMS、儀器控制與權限管理的流程。若每個實驗步驟都有版本、每次修正都有理由、每次例外都有人可以接管,AI 才可能從助手變成研究營運的一部分。
這也是為何「一小時」值得被記住,卻不該被單獨拿來下結論。它像新廠房第一次把一條產線跑通:證明線路接得起來,不代表明天就可以日夜量產。接下來要驗證的是停機時誰發現、不同設備的公差怎麼處理、模型推薦錯誤時是否能回溯,以及團隊是否願意改變原本的簽核習慣。這些看似不炫目的環節,才決定導入後的成本曲線。
🧭 09|台灣若要試,最適合從「可輸也可贏」的題目開始
台灣的優勢不是把一個海外 demo 重新命名成供應鏈題材,而是有足夠密集的材料、半導體、醫院與製造場景,能把這種系統放進高壓環境測試。最好的第一題未必是追求一個驚人的新發現,而是找一個已有明確量測、失敗成本可控、參數空間大、而且跨班組交接頻繁的流程。
例如,團隊可以先要求系統在既定安全範圍內提出下一輪實驗,而非直接放行任何危險條件;同時保留人工覆核、原始量測、版本紀錄與拒絕理由。若它能讓「這組條件為何被選中、哪次量測支持它、下一次怎麼改」在幾分鐘內被另一位工程師重新理解,這才是可驗證的生產力。反過來,若每次成功都得靠同一位高手在旁邊翻譯模型,那就只是更漂亮的展示。
對管理層而言,下一季應追的不是模型宣傳,而是四個可查的里程碑:是否有外部研究單位獲得明確權限;是否有不同設備的重現資料;是否公布失敗、例外與人工介入如何處理;以及是否出現把設備、資料治理與實際研究成果一起揭露的案例。這些訊號會比任何單點 benchmark 更早告訴我們,Google 是否把 AI for Science 從實驗室秀,推向一門可被採購的生意。
🧱 10|別把「自動化」和「可被信任」當成同一件事
在研發現場,最昂貴的失敗不一定是一次實驗沒有長出材料,而是團隊花了幾週才發現:成功其實來自一個沒有被記錄的手動調整,失敗則來自上一版程式改過一個參數卻沒人知道。當 AI 開始參與實驗,這個問題只會更尖銳。它可以替人加快假說和參數搜尋,但若推薦過程、資料來源與人工覆核沒有留下證據,速度會把不可追溯的錯誤放大。
因此,好的導入標準不該是「模型有沒有完全自動做完」,而是每一次建議能否被拒絕、被修改、被重播。研究主管需要看得到模型用過哪些限制條件;設備工程師需要知道哪段指令可被安全執行;品質或法遵人員需要找得到誰在何時核准。這些能力很少出現在 demo 的第一張投影片,卻是企業願意把珍貴研究流程交出去的前提。
如果 Google 能把這一套責任鏈做成通用能力,通用模型的規模、雲端與既有研究工具入口會形成很強的組合。若做不到,垂直軟體、儀器商與實驗資料系統仍能守住最難替換的那一段:把物理世界的資料變成可被品質系統承認的證據。AI for Science 的競爭不會只剩一家勝出,而會在閉環裡重新分配誰擁有資料、控制權與議價權。
🎯 結語|AI 科學家真正的考試,現在才開始
Google Co-Scientist 已經跨過一道重要門檻:在特定情境裡,它能把答案轉成程式或機器指令,讓實驗真的跑起來。
但它沒有把科學家移出流程。
人類仍在定義問題、裝載樣品、處理物理世界、判讀結果與承擔責任;AI 最強的地方,是把原本斷開的構思、執行、回饋與寫作接得更緊。
所以,約一小時長出三種單層材料值得關注;更值得關注的是,下一次換一台設備、換一座實驗室、換一個研究團隊,結果還能不能重現。
當答案是「可以」,AI for Science 才真正從展示,變成基礎設施。
—
一級來源:Google 團隊 arXiv 預印本 *Accelerating Scientific Research with Gemini in the Real-World*、Google DeepMind Co-Scientist、Google Gemini for Science、Google Labs Science。
本文為 AI 與生技產業資訊整理,不構成醫療或投資建議。預印本尚待同儕評審;研究 benchmark、實驗案例與產品預覽皆不等同臨床核准、商業採用或研發成功率。
引用本文
若在簡報、報告或社群討論引用,建議附上 Drugnews 原文連結。
Drugnews 編輯部,〈AI 一小時做完實驗?Google Co-Scientist 真正跨過的,是「動手」這一關〉,Drugnews|藥時事,2026/09/11,https://drugnews.com.tw/articles/2026-09-11-google-coscientist-real-world-lab-loop.html